Vier weken geleden sloot ik het eerste stuk over deze kaart af met een vuistregel: dense architectuur, AWQ of GPTQ, minstens zes maanden oud. Alles wat nieuwer was, ging stuk op kernelniveau, en er leek weinig aan te doen.
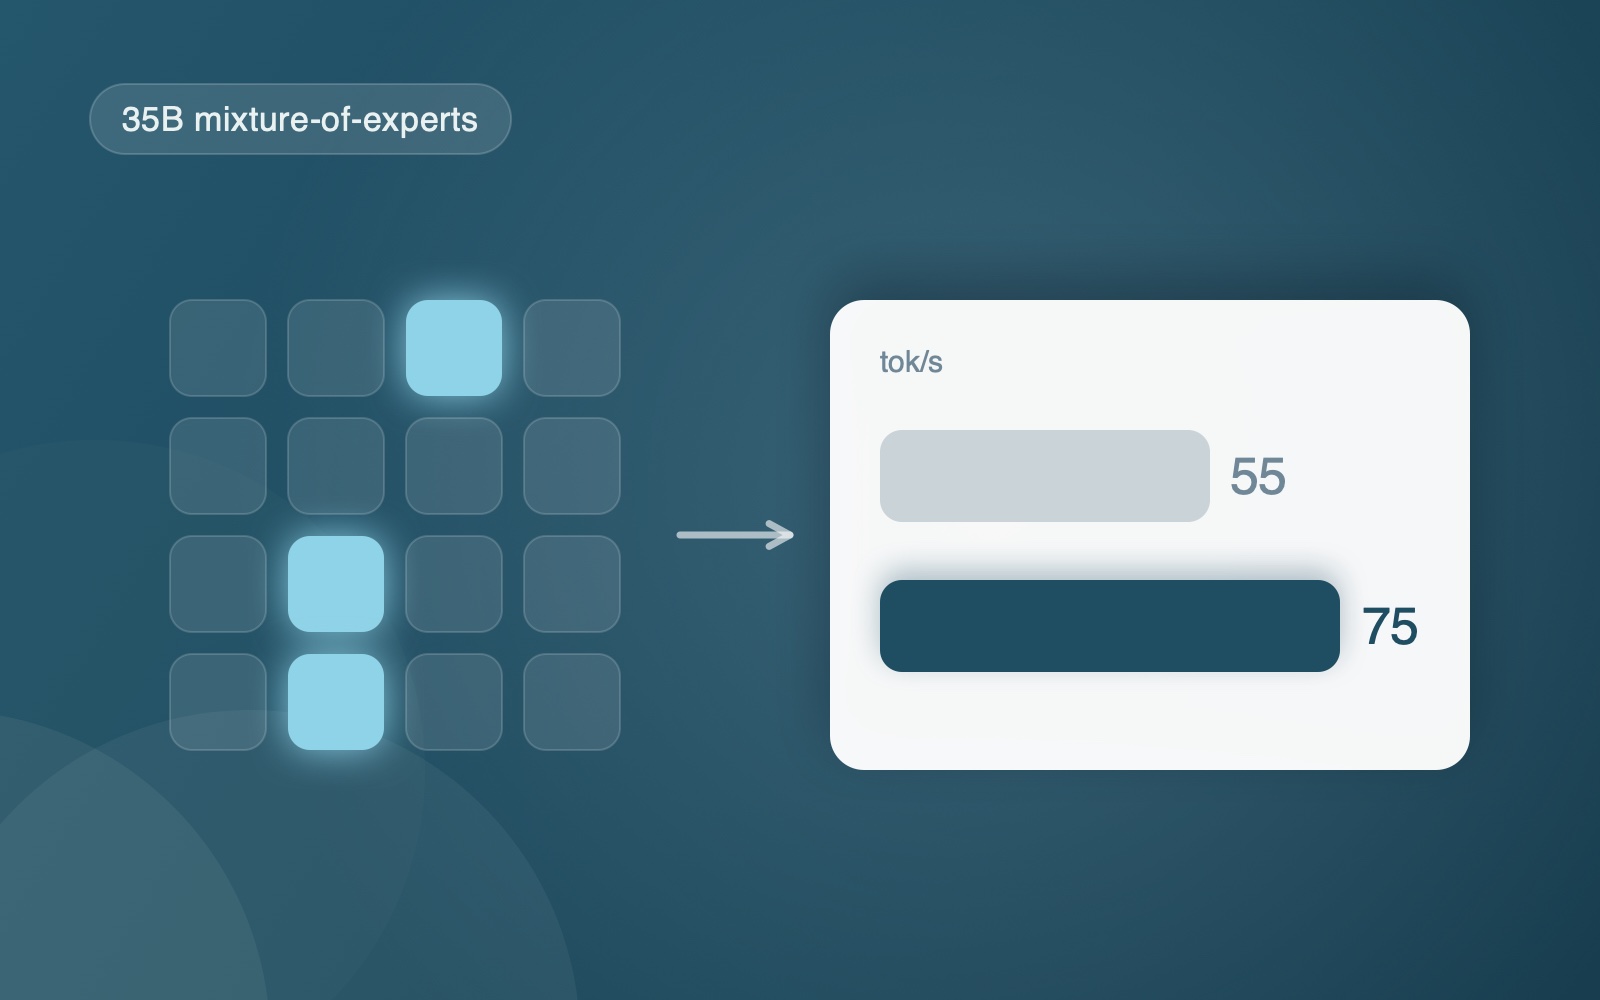
Die regel klopt niet meer, en daar ben ik blij om. De machine draait nu Qwen3.6-35B-A3B, een mixture-of-experts-model, op dezelfde Arc Pro B70. Het is tweeënhalf keer zo groot als wat ik in juli draaide, en het produceert sneller tokens.
Wat er echt veranderde
Eén ding: de runtime. vLLM is vervangen door llama.cpp, gebouwd tegen SYCL, dat het model precies zoals eerst op poort 8000 serveert. LiteLLM ervoor hoefde geen enkele regel te veranderen, en daarmee komt het argument van het tweede artikel onaangekondigd binnen.
De vLLM-service staat nog op de machine, met een Conflicts=-regel tegen de llama.cpp-unit, zodat de twee nooit tegelijk de GPU kunnen claimen. Terugschakelen is één systemctl start verwijderd. Die is ongebruikt gebleven.
| Juli, op vLLM | Nu, op llama.cpp | |
|---|---|---|
| Model | Qwen3-14B-AWQ, dense | Qwen3.6-35B-A3B, mixture of experts |
| Kwantisatie | AWQ 4-bit | Q4_K_M |
| Doorvoer | 55 tok/s | 69.7, 75.1 en 75.7 tok/s over drie runs |
| Context | 131k | 131k |
| Concurrency | 1.93x | één verzoek tegelijk |
De regel ging de hele tijd over de runtime
Dit is het deel dat het opschrijven waard is. Alles wat in dat eerste artikel stond over kapotte kernels was waar, en ik heb het allemaal eerlijk gemeten. Wat ik fout had, was de conclusie die ik eruit trok. Ik behandelde een beperking van de XPU-kernels van Intel binnen vLLM alsof het een eigenschap van de kaart was.
Een gekwantiseerd mixture-of-experts-model was precies het soort ding dat vroeger bij de eerste echte inferentie omviel. Op llama.cpp laadt en draait het, alle 99 lagen op de GPU, flash attention aan, key- en value-cache op q8_0. De hardware had nooit een mening over mixture-of-experts. Eén stuk software wel.
Heb je zo’n kaart en ben je nieuwere architecturen uit de weg gegaan omdat iemand ze heeft zien falen, probeer dan eerst de andere runtime voordat je je daarbij neerlegt.
Wat het kost
Vooral concurrency. llama.cpp draait hier met --parallel 1, dus verzoeken staan in de rij in plaats van elkaar te overlappen. vLLM haalde 1.93 gelijktijdige streams bij deze contextlengte. Voor één persoon en een handvol geplande taken is dat nog geen enkele keer de bottleneck geweest, en voor een model van dit formaat op deze snelheid zou ik er nog flink meer voor inleveren. Op een machine die meerdere mensen bedient, zou het het eerste zijn om opnieuw naar te kijken.
Eén argument uit het eerste artikel is ook stilletjes ingestort. Beeldanalyse zat op de processor omdat een vLLM-instantie 130 seconden nodig had om zijn eerste token te produceren, en voor de af en toe langskomende foto overheerste dat wachten alles. De huidige opstelling houdt het model in het geheugen en laadt de vision projector ernaast, dus afbeeldingen gaan nu door hetzelfde model op de GPU. De aparte route via de CPU is weg, en daarmee kwam 4,1 GB RAM terug.
Hierna
Qwen 3.8 MoE, zodra het beschikbaar is. Als het patroon van deze ronde standhoudt, is de interessante vraag niet of de kaart het aankan, maar of llama.cpp op dag één de kernels klaar heeft. Ik meet het op dezelfde manier en meld wat eruit komt, ook als het niet werkt.